Historische Einordnung: Dieser Beitrag entstand im Januar 2023 und wurde Anfang 2024 ergänzt. Die Beispiele, Modellnamen und Produktoberflächen beziehen sich auf diesen Zeitraum. Die zentrale Unterscheidung ist zeitübergreifend: Ein Sprachmodell allein ist keine Websuche. Bei einem suchgestützten Assistenten müssen zusätzlich die abgerufenen Quellen und die daraus erzeugte Antwort geprüft werden.
Dies ist eine kleine Artikelserie zu ChatGPT, dem aktuell wahrscheinlich spannendsten Thema für viele im Bereich des Online Marketings. In diesem Teil, erkläre ich, was ChatGPT ist, was es nicht ist, was es kann und was es nicht kann. Im zweiten Teil erkläre ich dann wieso Google noch nicht ein solches Interface anbietet und ob bing und You mit Chatbot-Funktionen Google wirklich gefährlich werden kann und im dritten Teil stelle ich zwei Text-Chatbots vor, die bereits heute mehr können, als ChatGPT.
In meinem Artikel zu GPT-3 habe ich bereits erklärt: GPT ist ein Sprachmodell und wurde konzipiert, um natürliche Sprache und dessen Struktur abbilden zu können.
Diese Sprachmodelle lassen sich unterschiedlichen Methoden und Layern „fine-tunen“, in dem man sie dazu „erzieht“ bestimmte Dinge eher zu tun und andere Dinge zu lassen. ChatGPT ist genau ein solches, „finegetuntes“ GPT-3.5.
Wieso benutzt man nicht einfach GPT-3?
Die klassischen GPT-3-Modelle, die man bereits seit einiger Zeit via API bei OpenAI nutzen kann, sind nicht darauf trainiert, Benutzeranweisungen in natürlicher Sprache zu befolgen.
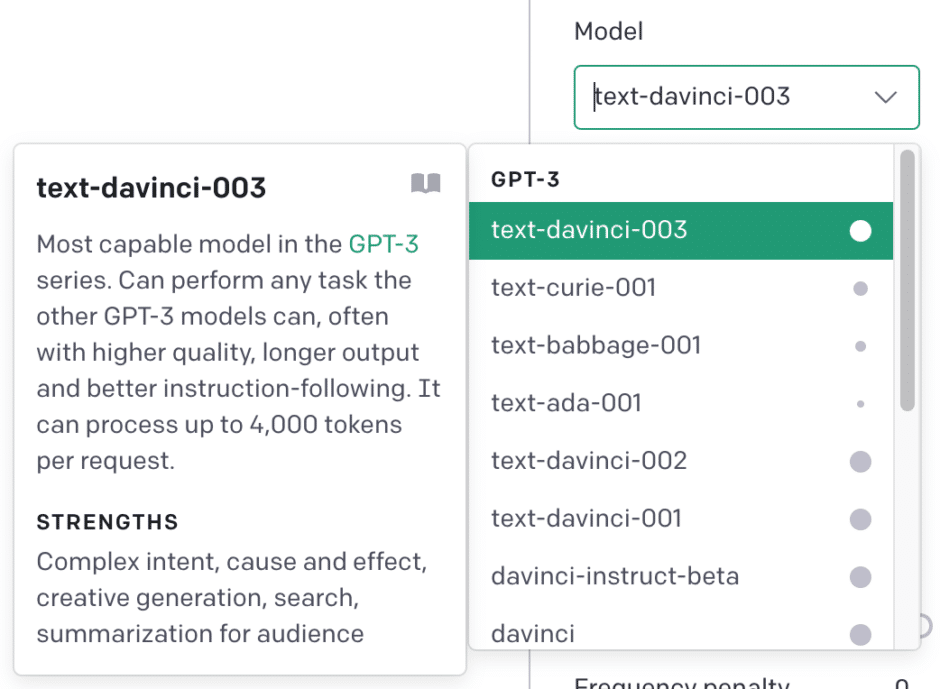
Das derzeit mächtigste Modell von GPT-3 „text-davinci-003“ (auch GPT-3.5 genannt) ist in der Lage bis zu 4.000 Token auf einmal zu verarbeiten, die sich jedoch auf Input und Output gemeinsam beziehen! Das bedeutet: Je länger also die an das Modell gestellte Anfrage ist, desto kürzer wird der mögliche Output, weil das Fenster nicht erweitert werden kann.
Prompt-Engineering als Hürde
Um mit GPT-3 sinnvolle Ergebnisse zu erhalten, muss man also etwas Verständnis und Einarbeitungszeit mit bringen, um das sogenannte Prompt-Engineering zu beherrschen, also die Formulierung von Anfragen an das Sprachmodell. Das erklärt übrigens auch, wieso spezialisierte KI-Text-Tools wie jasper, frase und Co. für viele Nutzer einfacher zu benutzen sind und man damit schneller zu besseren Ergebnissen kommt. Diese nehmen einem quasi das Prompt-Engineering ab und liefern bewährte Templates und optimierte User Interfaces.
Warum Anweisungsbefolgung wichtig wurde
Irgendwann wurde die OpenAI-API dann für alle geöffnet und unbedarfte Nutzer konnten über den Playground plötzlich ohne Vorkenntnisse oder Programmierkenntnisse mit GPT-3 spielen. Dass Sprachmodelle Benutzeranweisungen nicht zuverlässig befolgten, war ein Problem für ihre praktische Nutzung. Die folgende Erklärung beschreibt vereinfacht den Ansatz des damaligen ChatGPT-Trainings; eine konkrete Produktentscheidung aufgrund gescheiterter Playground-Nutzer ist damit nicht belegt:
- Man fine-tuned ein vortrainiertes GPT-3-Modell mittels sogenanntem „Reinforcement Learning from Human Feedback (RLHF)“, was nichts anderes bedeutet als, das zunächst menschliche KI-Trainer komplette Gespräche vorgaben, in denen sie beide Seiten spielten, also den Nutzer und einen KI-Assistenten. Diese Daten wurden sozusagen als Grundmodell mittels SFT auf GPT geprägt, damit GPT grundsätzlich Dialoge führen kann.
- Anschließend wurden neue Anfragen an das geprägte Modell gestellt und menschliche Labeler haben die Antworten nach dessen Qualität sortiert. Diese Daten wurden genutzt, um eine Art Belohnungssystem (RM) zu trainieren, das bei besseren Antworten größere Belohnung ausschüttet, als bei schlechten Antworten, damit GPT quasi lernen kann immer bessere Antworten zu liefern.
- Nun konnte die ursprünglich durch Menschen geprägte Policy im ersten PPO-Modell mittels des Feedbacks des trainierten Reward Modells immer weiter verbessert und verfeinert werden.

Dadurch erzeugt ChatGPT viel hilfreichere Ergebnisse als Reaktion auf Benutzeranweisungen als reguläre GPT-3-Modelle. Okay, soweit so gut.
Was kann ChatGPT nicht?
Im Kern ist ChatGPT also eine Art spezialisierte Version von GPT-3.
Wie auch GPT schreibt ChatGPT daher manchmal plausibel klingende, aber falsche oder unsinnige Antworten.
Denn, GPT erzeugt Text schrittweise anhand berechneter Wahrscheinlichkeiten für Tokens. Dabei kann das Modell gelernte Zusammenhänge nutzen; die Generierung selbst ist aber kein Nachweis für die Wahrheit der Aussage.
Dieses Problem zu beheben, ist eine Herausforderung, wie OpenAI selbst schreibt, denn:
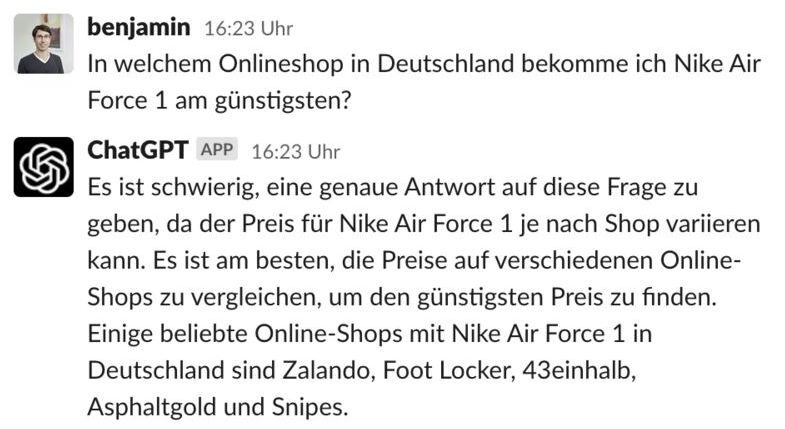
Während des fine-tuning des Modells gibt es derzeit keine Quelle der Wahrheit. Daher wurde das Modell darauf trainiert wird, etwas vorsichtiger zu sein, was dazu führt dass es Fragen ablehnt, die es „glaubt“ nicht richtig beantworten zu können, wie man in diesem Beispiel sehen kann:
Einschub: Wie kommt mein Unternehmen in ChatGPT?
Die genannten Shops können mit den im Modell gelernten Zusammenhängen zu tun haben. Aus dieser einzelnen Antwort lässt sich jedoch weder ihre Häufigkeit in den Trainingsdaten noch die Ursache der Auswahl bestimmen. Falls Du Dich also fragst, wie Dein Unternehmen „in ChatGPT“ kommt:
Bekanntheit und konsistente, öffentlich zugängliche Informationen können eine Rolle spielen. Eine bestimmte Nennung lässt sich daraus nicht garantieren; bei suchgestützten Antworten kommt die Auswahl abgerufener Quellen hinzu.
Leider führt das überwachte Training das Modell in diesem Konstrukt auch zum Teil in die Irre, weil die ideale Antwort immer davon abhängt, was das Modell weiß, und das Modell nicht wissen kann, was der menschliche Labeler weiß, der die Antworten bewertet.
Die damaligen Beispiele zeigen Antworten ohne Webzugriff. Eine URL im Prompt beweist nicht, dass ihr Inhalt abgerufen wurde. Such- oder Abrufwerkzeuge müssen tatsächlich verfügbar und genutzt sein; auch dann ist eine sachliche Validierung der Antwort nötig.
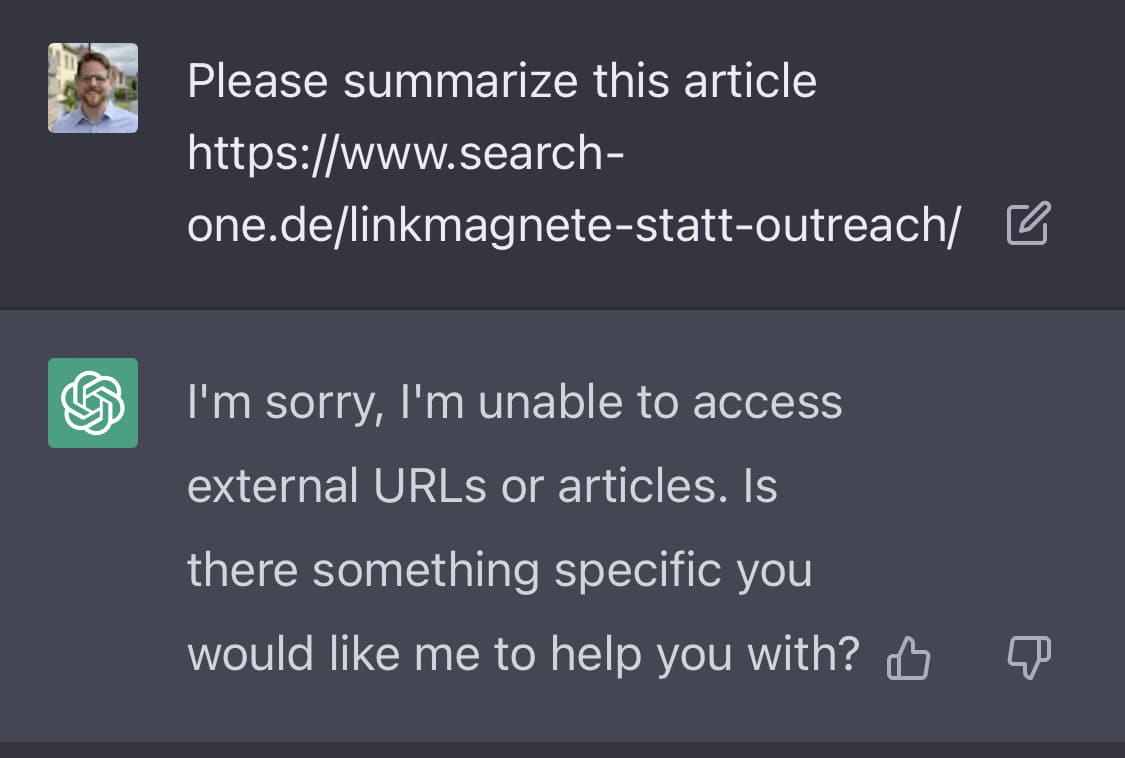
Wenn man also beispielsweise fragt:
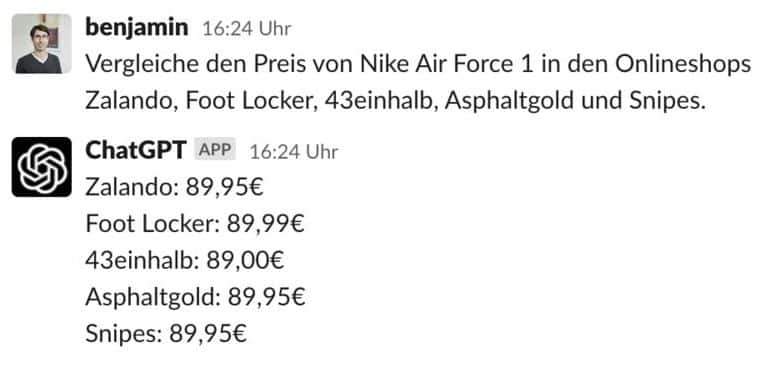
Ohne Abruf einer aktuellen Preisquelle sind die ausgegebenen Preise nicht belastbar. Sie können aus gelernten Mustern oder einer frei erzeugten plausiblen Fortsetzung stammen. Ein Trainingsstichtag sagt zudem nicht, wann jeder einzelne verwendete Inhalt entstanden ist.
In diesem Fall ist es sogar sehr viel wahrscheinlicher, dass die Preise nicht korrekt sind und es auch nie waren. Sprachmodelle können auch seltene Informationen lernen oder memorieren. Daraus folgt aber weder eine zuverlässige Speicherung eines konkreten Preises noch dessen Aktualität. Für einen Preisvergleich braucht es überprüfbare Quellen mit Datum und passenden Produktbedingungen.
Wenn Statistik lügt
Ich habe ein perfektes Beispiel für den Umgang mit Fakten und der Bedeutung der Promts für #ChatGPT gefunden:
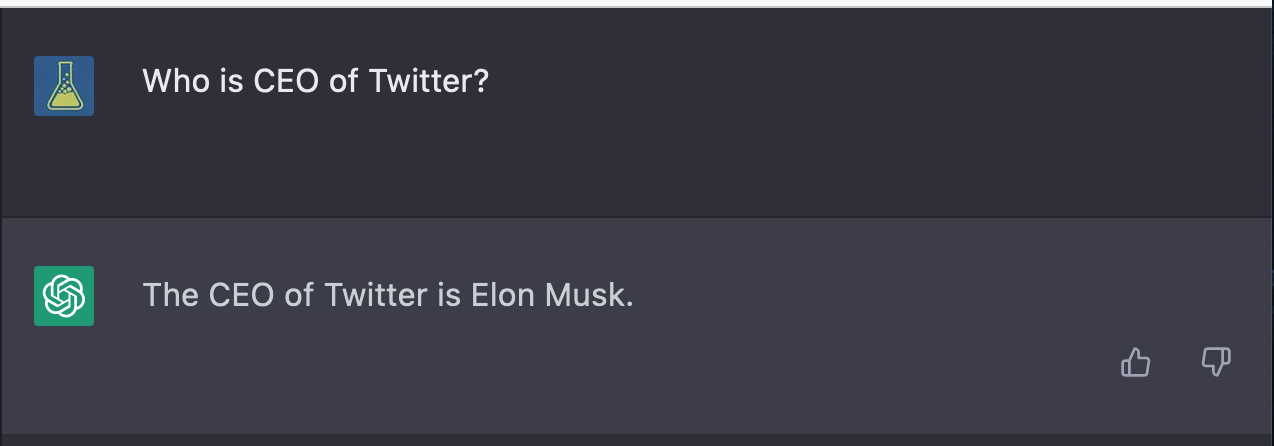
Auf die Frage „Wer ist CEO von Twitter“ liefert die KI die (richtige) Antwort Elon Musk, die es eigentlich nicht kennen kann, denn zum Zeitpunkt des Trainings im November 2021 war noch Jack Dorsay der CEO:
Fragt man allerdings „Wer ist CEO der Twitter, Inc.“ antwortet die KI (in ihrem Kontext korrekt) mit dem Hinweis, dass sich diese Information in der Zwischenzeit geändert haben könnte.
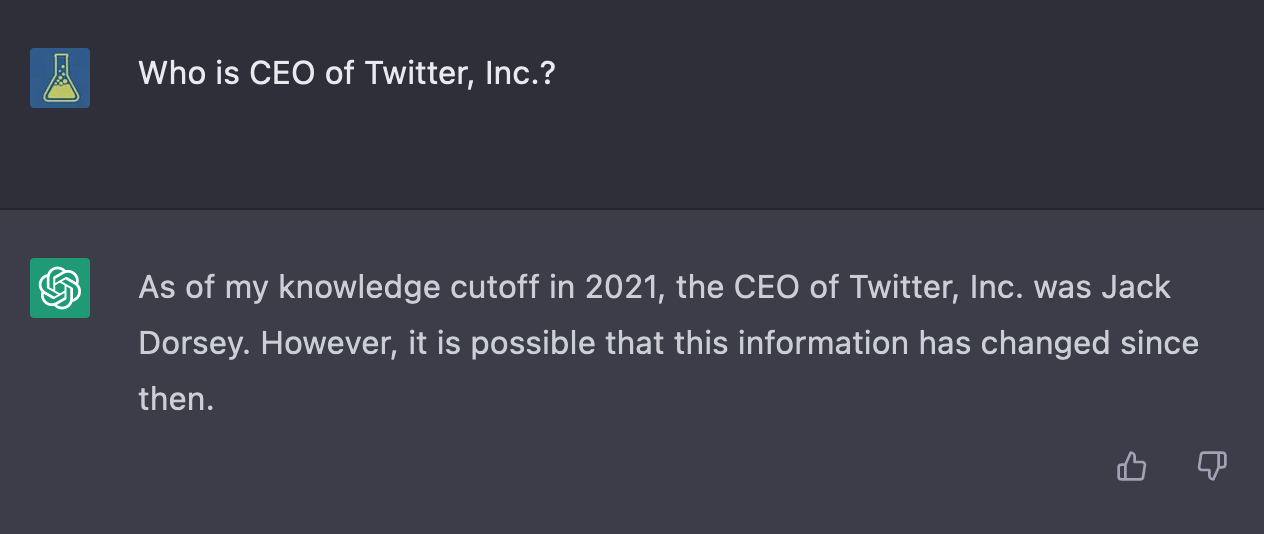
Die beiden Antworten zeigen, dass eine kleine Änderung der Formulierung zu unterschiedlichen Ergebnissen führen konnte. Warum das Modell jeweils diese Antwort erzeugte, lässt sich aus den Screenshots allein nicht bestimmen. Meine damalige Erklärung über die Häufigkeit von Namen war eine Hypothese, kein Nachweis.
Die Spezifizierung auf „Twitter, Inc.“ änderte in diesem Beispiel die Antwort. Daraus lässt sich keine allgemeine Regel ableiten, mit der Entitätsnamen stets korrekte Fakten liefern.
Wieso „trainiert“ man ChatGPT nicht mit aktuellem Wissen?
Auf meinen Hinweis, dass es sich dabei nicht um korrekte Antworten handelt, kommt oft der Vorschlag, man müsse doch nur das Modell mit aktuelleren Daten trainieren und schon müssten die Informationen doch korrekt sein. Doch das ist nicht richtig. Denn:
Sprachmodelle lassen sich mit neuen Daten weitertrainieren, doch das ist mit Aufwand verbunden und garantiert keine jederzeit aktuellen, korrekten Antworten. Eine Mehrheit aller Dokumente ist keine notwendige Bedingung, damit ein Modell einen neuen Fakt lernt. Für wechselnde Informationen ist ein gezielter Abruf aktueller Quellen häufig der zweckmäßigere Ansatz.
Dass GPT-3 überhaupt in der Lage ist, zu vielen Anfragen plausibel klingende und zum Teil auch korrekte Informationen wiederzugeben, ist das Ergebnis der Tatsache, dass diese Information sehr häufig in den Trainingsdaten enthalten war und sich daher (neben der Grammatik der Sprache) im Modell abgebildet wurde.
GPT ist grundsätzlich nicht besonders dazu geeignet Informationen und Fakten abzuspeichern und wiederzugeben! Für einen derartigen Fall gibt es wesentlich bessere und effizientere Methoden.
In den Modellparametern können Informationen und Zusammenhänge aus dem Training repräsentiert sein. Sie liegen dort jedoch nicht als einzeln abrufbare, mit Quellen und Aktualisierungsdatum versehene Datenbankeinträge vor. Der Vergleich mit menschlicher Erinnerung ist eine Analogie und keine technische Erklärung des Modells.
ChatGPT als Suchmaschine?
Aus dem letzten Absatz sollte klar geworden sein, wieso ChatGPT (ohne ein Suchsystem dahinter) nicht dazu geeignet ist, als Suchmaschine verwendet zu werden, auch wenn viele trotzdem tun!
Ein Sprachmodell ohne Abrufwerkzeug kann nicht live auf Webseiten zugreifen. Mit einer Such- oder Abrufanbindung ist ein solcher Zugriff möglich; überprüfbare Antworten entstehen dadurch trotzdem nicht automatisch.
Es gibt KI-getriebene Suchmaschinen
Die Ergänzung von Anfang 2024 beschrieb Suchmaschinen-getriebene KI-Chatbots: Google experimentierte damals mit Bard, Microsoft verband die Bing-Suche mit Sprachmodellen und verwendete zunehmend den Namen Copilot. Diese Produktnamen und Oberflächen dokumentieren den damaligen Stand; aus der Kooperation lässt sich kein bestimmter Anteil an OpenAI ableiten.
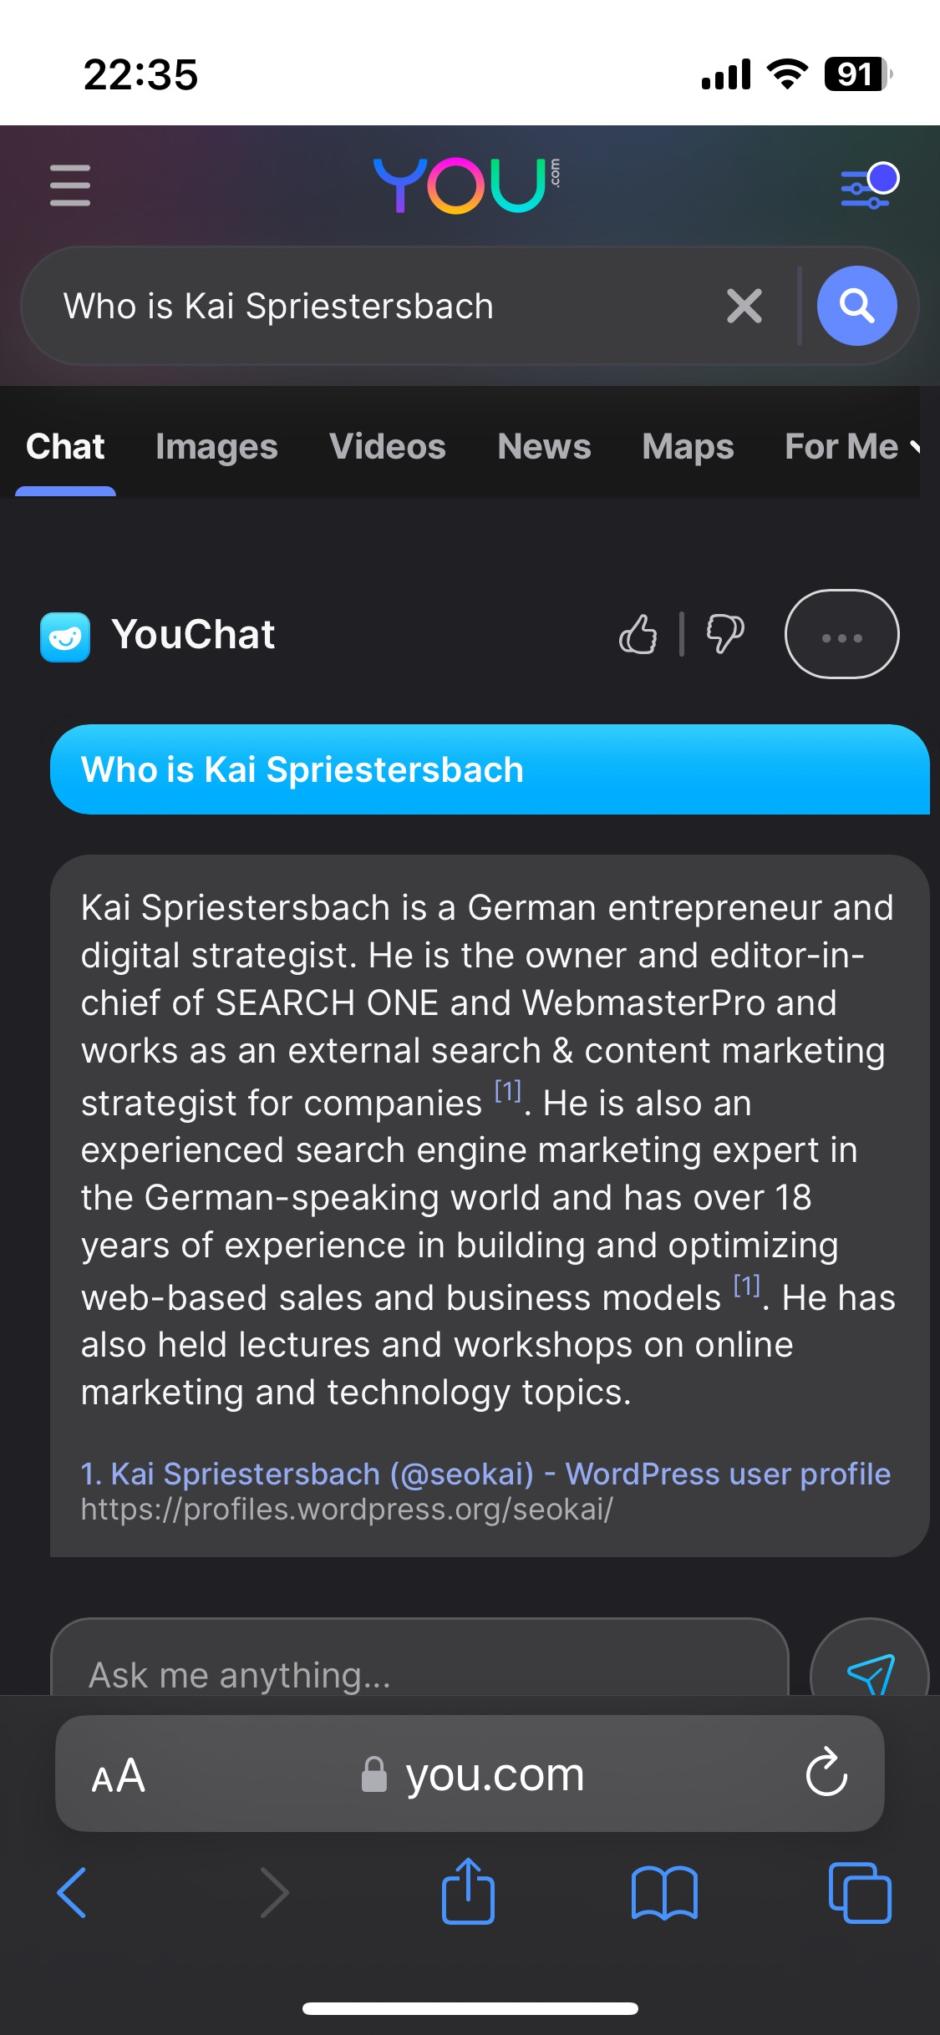
Wie so etwas aussieht, liesst sich aber schon länger bei der Suchmaschine von KI-Wunderkind Richard Socher unter You.com in Form von You Chat ausprobieren!
Ebenfalls vor bing und Google hat es perplexity geschaft eine sehr vielversprechende Suchmaschine auf Basis von LLMs zu bauen und stand Anfang 2024 mit einer angekündigten Finanzierungsrunde im öffentlichen Fokus.
Durch den RAG-Ansatz, bei dem die gewünschten Informationen mittels klassischer Information Retrieval Methoden gefunden und diese als Quellen quasi zusammengefasst werden, sind die Informationen deutlich verlässlicher.
Man verwendet hierbei ein zusätzliches Layer, das aus der Nutzeranfrage eine Suchanfrage an den Webindex erstellt. Diese Suchanfrage wird im Hintergrund ausgeführt und Informationen aus ausgewählten gefundenen Quellen werden extrahiert und wiederum dem Sprachmodell zur Verfügung gestellt. Das Modell erstellt aus der Nutzerfrage und den Inhalten der rankenden Seite schließlich eine Antwort, sozusagen als Zusammenfassung.
Die Qualität dieser Systeme hängt sowohl von Suchtechnologie und Quellenwahl als auch von der Verarbeitung durch das Sprachmodell und der Prüfung der Antwort ab.
Allerdings leiden sämtliche LLM-getriebene Suchsysteme, also auch perplexity noch unter Halluzinationen und liefern zum Teil falsche Informationen, trotz korrekter Inputs durch die Quellen.
Ein Abrufsystem ermöglicht den Zugang zu aktuellen Quellen, ohne das Modell für jede Änderung neu zu trainieren. Es garantiert jedoch keine aktuelle oder korrekte Antwort. Ein möglicher Ansatz ist, die Nutzerfrage in eine Suchanfrage zu überführen und passende Ergebnisse als Kontext bereitzustellen. Zugriffsrechte, Quellenqualität, Aktualität und korrekte Zuordnung der Antwort müssen zusätzlich abgesichert werden.
Textgenerierung ist die Grundlage.
Verlässliche Recherche braucht zusätzlich Quellen, Abruf und Prüfung.
Natürlich kannst Du jetzt einfach ein Sprachmodell vor deine Datenbank packen. Dann hast du sofort einen vollautomatisierten Chatbot. Theoretisch zumindest, denn in der Praxis ist es extrem schierig mit unerwarteten Anfragen umzugehen und die Nutzererwartung nicht zu enttäuschen.
Abonniere das AFAIK-Update
KI verstehen. Fundiert entscheiden. Wirksam umsetzen.
Im AFAIK-Update teile ich meine Einordnungen und Erfahrungen zu KI im Unternehmen: von Strategie und sinnvollen Anwendungsfällen über die Auswahl passender Lösungen bis zur praktischen Umsetzung. Kostenlos, persönlich und mit einem klaren Blick auf Chancen und Grenzen.
Keine Sorge, ich mag Spam genauso wenig wie Du und gebe Deine Daten niemals weiter! Du bekommst höchstens einmal pro Monat eine E-Mail von mir. Versprochen.