Peec AI hat mit „Primary Sources“ einen 66 Seiten starken Report zum Stand der KI-Suche vorgelegt: 700 befragte Marketing-Entscheider, dazu eigene Plattformdaten zu ChatGPT, Google und Claude. Die Botschaft: Nicht die Größe eines Unternehmens entscheidet über den Erfolg, sondern wie es sich aufstellt. Das klingt gut. Nur beweisen die Daten das leider nicht.
Ich habe den Report „Primary Sources, Q3 2026“ gelesen, die Grafik zu den ChatGPT-Zitationen geprüft und zentrale verlinkte Quellen nachverfolgt. Mein Eindruck: ein lesenswertes Stimmungsbild mit einigen wirklich interessanten Beobachtungen – und einer Reihe von Schlüssen, die ich so nicht übernehmen würde.
Was Peec untersucht hat
Wichtig vorab: Der Report verbindet zwei Untersuchungen zum selben Thema. Ihre Daten werden aber nicht auf Unternehmensebene miteinander verknüpft. Wir erfahren also nicht, ob die befragten Unternehmen in Peecs Plattformdaten tatsächlich besser abschneiden.
Die erste Untersuchung ist eine Umfrage. Sapio Research hat im September und Oktober 2026 700 Marketing-Entscheider in den USA (300), Großbritannien (200) und Deutschland (200) befragt. Alle arbeiten in Unternehmen ab 100 Beschäftigten, mindestens auf Manager-Ebene, und sind für KI-Suche ganz oder teilweise verantwortlich.
Der zweite Teil stammt aus Peecs eigener Plattform. Er zeigt für das dritte Quartal, wie ChatGPT sucht (Fan-Out-Queries), und welche Quellen ChatGPT, AI Overviews, AI Mode, Gemini und Claude zitieren.
Die Schlagzeilen: 89 Prozent haben ihr Budget erhöht, aber nur 24 Prozent können nach eigener Aussage einen Return on Investment belegen. Bei Befragten mit integrierter Strategie (Die AI-Search-Strategie ist Teil der übergeordneten Marketing- oder Go-to-Market-Strategie) liegt dieser selbst berichtete ROI-Nachweis fast doppelt so hoch wie bei einer unabhängigen GEO-Initiative (43 gegenüber 23 Prozent). . Beispielsweise berücksichtigen Content, PR und Produktmarketing KI-Sichtbarkeit in ihren gemeinsamen Zielen und Maßnahmen.
Was ich dem Report abnehme
Fangen wir mit dem an, was trägt.
Die unterschiedlichen Einschätzungen nach Hierarchieebene sind für mich der stärkste Befund der Umfrage. 49 Prozent der Inhaber und C-Level-Befragten sagen, sie hätten verlässliche Metriken. Bei den Managern sind es 29 Prozent, Directors und VPs liegen dazwischen. Der Abstand ist groß und die Abstufung konsistent. Befragte auf Manager-Ebene sind skeptischer. Ob Geschäftsführung und Fachteam desselben Unternehmens auseinanderliegen, wissen wir allerdings nicht: Eine solche gepaarte Befragung wird nicht beschrieben.
Die Plattformen unterscheiden sich deutlich. YouTube macht laut Peec 7,7 Prozent der Quellen in AI Overviews aus, in ChatGPT 0,2 Prozent. Die genauen Werte hängen davon ab, welche Prompts Peec auswertet, aber genau das verrät der Report nicht. Die Richtung halte ich trotzdem für plausibel.
Einzelne Prompt-Abfragen sind noch keine belastbare Sichtbarkeitsmessung. Sie zeigen eine Antwort auf eine Formulierung zu einem bestimmten Zeitpunkt. Sprachmodelle können dieselbe Frage unterschiedlich beantworten. Wer daraus die Sichtbarkeit einer Marke ableitet, braucht mehr als einen Screenshot.
Fair finde ich außerdem, dass der Methodenteil ausdrücklich sagt: Die Angaben sind Selbstauskünfte, und Zusammenhänge belegen keine Kausalität.
Schade nur, dass mehrere Schlagzeilen und Empfehlungen diese Grenze wieder überschreiten.
Selbstauskunft trifft Selbstauskunft
Die Kernthese lautet „Setup beats size“. Belegt wird sie damit, dass Befragte mit integrierter Strategie häufiger sagen, sie könnten ROI nachweisen.
Hier lohnt ein zweiter Blick: Die Befragung misst nicht, ob diese Unternehmen in KI-Antworten sichtbarer sind oder mehr Umsatz machen! Gemessen wurde nur, wer von sich sagt, das belegen zu können!
Was genau als ROI-Nachweis zählt, legt der Report nicht offen. Eine unabhängige Prüfung von Umsätzen, Kosten oder Berechnungen wird nicht beschrieben. In den Empfehlungen werden daraus dann Unternehmen, die „Ergebnisse erzielen“.
Eine Selbstauskunft über die eigene Messbarkeit ist noch kein Erfolgsnachweis.
Dazu kommt ein Problem, das der Report selbst liefert: 270 der 700 Befragten sind Inhaber oder C-Level, also fast 39 Prozent. Genau diese Gruppe antwortet durchweg optimistischer. Eine generell optimistischere Selbsteinschätzung könnte sowohl die Beschreibung der eigenen Strategie als auch die Bewertung ihrer Messbarkeit beeinflussen. Eine Analyse, die Hierarchieebene, Land oder Budgethöhe gemeinsam berücksichtigt, wird nicht ausgewiesen. Dabei liegt die ROI-Angabe in den USA bei 31 Prozent und in Deutschland bei 18.
Und was ist mit der Größe? Unternehmen mit 100 bis 999 Beschäftigten und solche ab 1.000 berichten jeweils zu gerundet 24 Prozent, ROI belegen zu können. Das ist kein Nachweis, dass Größe keine Rolle spielt. Kleine Unternehmen fehlen komplett; Beschäftigtenzahl ist außerdem weder Marketingbudget noch Markenbekanntheit. „Setup schlägt Größe“ bleibt eine Hypothese.
Auch die 89 Prozent würde ich nicht als Marktzahl lesen. Befragt wurden nur Menschen, die KI-Suche bereits verantworten. Das ist keine beliebige Auswahl von Unternehmen. Wer bereits jemanden für KI-Suche verantwortlich macht, dürfte anders auf das Thema schauen als jemand, der sich damit noch gar nicht beschäftigt. Wie die Teilnehmenden rekrutiert und die Ergebnisse gewichtet wurden, ist nicht ausreichend dokumentiert. Beträge nennt der Report ebenfalls nicht.
Wenn der Toolanbieter herausfindet, dass Tools helfen
Eines der drei „Zeichen von Commitment“ ist eine dedizierte AI-Visibility-Plattform. Das ist die Produktkategorie, die Peec verkauft.
Dass Nutzer einer speziellen AI-Visibility-Plattform ihren Metriken häufiger vertrauen als Nutzer von KI-Funktionen in bestehenden Tools (58 gegenüber 42 Prozent), überrascht mich nicht. Über die Qualität dieser Metriken sagt es jedoch nichts.
Ich halte solche Tools für nützlich, wenn man weiß, was sie messen. Aber Vertrauen in eine Zahl und die Gültigkeit dieser Zahl sind zwei verschiedene Dinge.
Bemerkenswert ist auch ein Zitat zum eigenen Research: Über „120 Millionen KI-Chats“ habe man herausgefunden, dass breite Prompt-Sets verlässlicher seien als wenige wiederholte Abfragen. Die Fußnote führt allerdings zu einem Beitrag im Search Engine Journal. Der ist als von Peec gesponsert gekennzeichnet, berichtet von rund 38.000 KI-Antworten über 5 Systeme und beschreibt keinen direkten Test dieses Vergleichs. Dort lässt sich die Zahl jedenfalls nicht nachvollziehen.
Die große Zahl findet sich aber tatsächlich in einer anderen Peec-Auswertung. Daraus berechnet Peec, warum ein breiteres Promptset bei gleichem Abfragebudget die Sichtbarkeit präziser schätzen kann.
Die methodische Einschränkung bleibt: Auch 120 Millionen Chats machen ein ausgewähltes Promptset nicht automatisch repräsentativ für die Fragen tatsächlicher Kunden.
Die Plattformdaten: Ich habe nachgemessen
Der interessantere Teil ist der zweite. Laut Peec stieg in ChatGPT der Anteil der Sessions mit mehreren Fan-out-Queries von 2 Prozent im Juli auf 61 Prozent im September. Reddit sei eingebrochen, Produktseiten hätten sich mehr als verdoppelt.
Als Auslöser nennt der Report den Wechsel auf GPT-5.6 als Standardmodell am 8. August. Die Prozentwerte beziehen sich auf Peecs ausgewertete Sitzungen. Da die Grafik keine Kategorie ohne Suche zeigt, bleibt der Umgang mit solchen Sitzungen unklar. Auf alle ChatGPT-Gespräche würde ich die Zahlen nicht übertragen!
Die Grafik auf Seite 56 zeigt indexierte Zitationsvolumina, der jeweilige Q2-Durchschnitt ist 100:
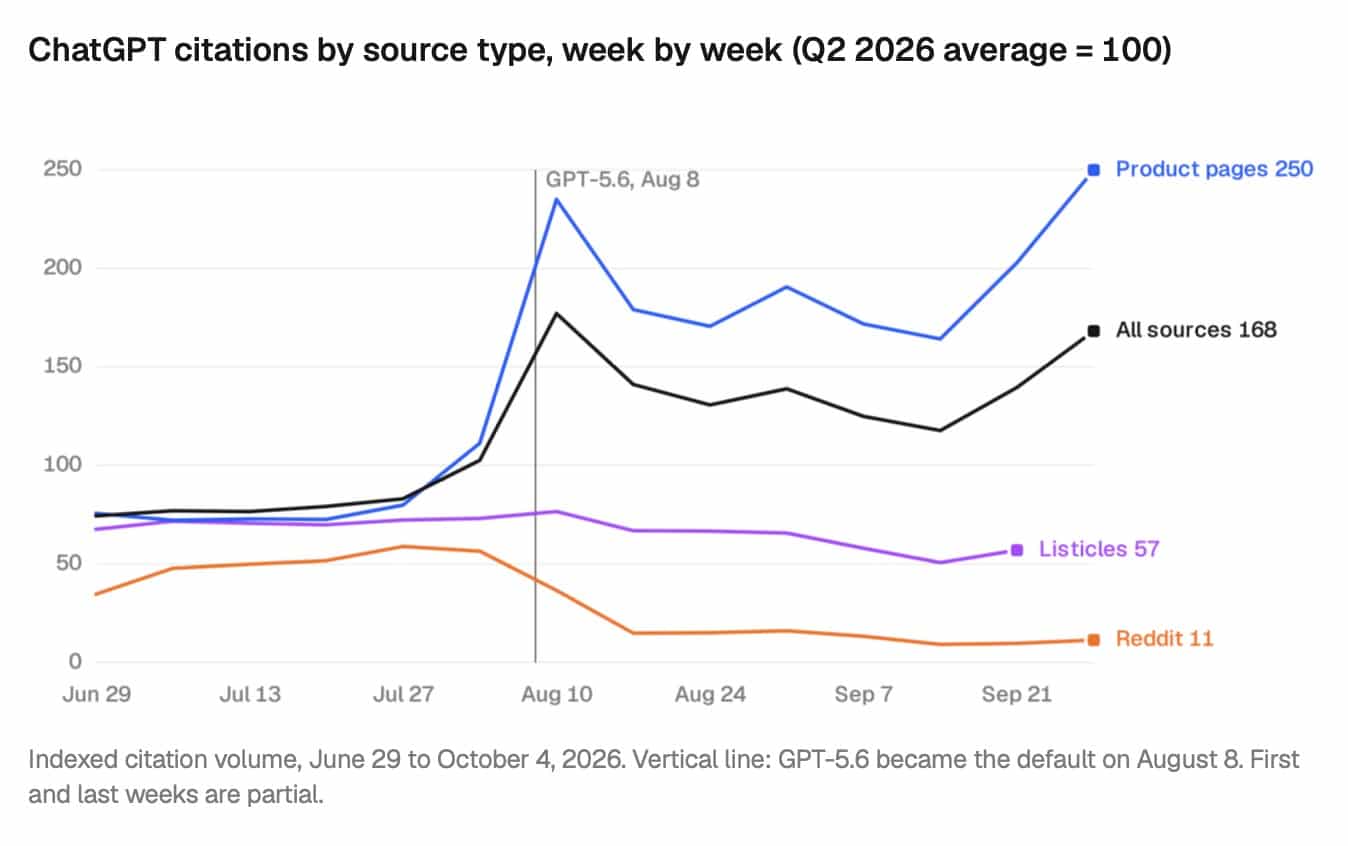
Ich habe die eingezeichneten Endwerte nachgerechnet und den Verlauf betrachtet. Drei Dinge fallen auf.
Erstens: Volumen ist nicht Anteil. Der Index aller Quellen steigt am rechten Rand auf 168, Produktseiten landen bei 250. Unter der Voraussetzung vergleichbarer Zählungen aus demselben Korpus entspricht das einem relativen Anteilszuwachs von rund 49 Prozent: 250 geteilt durch 168, minus eins.
Peecs Aussage über das mehr als verdoppelte Volumen bleibt richtig. Der relative Bedeutungsgewinn fällt aber deutlich kleiner aus. Wie stark mehr erfasste Antworten oder mehr Quellen pro Antwort zum Volumenanstieg beitragen, lässt sich aus der veröffentlichten Methodik nicht klären.
Zweitens: Reddit lag schon vorher niedriger. In den vollen Juliwochen liegt die Kurve grob bei der Hälfte des Q2-Niveaus. Das ist eine ungefähre Ablesung aus der Grafik, keine Auswertung von Rohdaten. Der starke weitere Rückgang kommt im August. Das niedrigere Niveau beginnt aber nicht erst am angegebenen Tag des Modellwechsels.
Drittens: Listicles verlieren relativ noch stärker. Der Index fällt auf 57. Bezogen auf den Gesamtindex von 168 entspricht das einem Anteilsrückgang von rund 66 Prozent gegenüber der Basisperiode – sofern die Reihen wie beschrieben vergleichbar sind. Weniger Zitationen sind allerdings noch kein Beleg dafür, dass eine Plattform eine bestimmte Taktik gezielt abwertet.
Die Datierung des Modellwechsels übernehme ich hier aus dem Report. Unabhängig vom genauen Stichtag bleibt es ein Vorher-nachher-Vergleich ohne Kontrollgruppe. Welchen Anteil das Modell, die Suche, die Oberfläche oder Änderungen an der Datenerfassung haben, lässt sich daraus nicht isolieren.
Gerade vor diesem Hintergrund überzeugt mich die pauschale Durchhalteempfehlung nicht.
Peecs CMO Malte Landwehr vergleicht den Abbruch von Third-Party-Mentions nach drei Monaten mit einem Fitnessstudio-Vertrag, den man nach einer Woche kündigt. Als Beleg dient eine eigene Listicle-Studie: Platz eins in einem zitierten Listicle „bringe“ 13 bis 17 Prozentpunkte Sichtbarkeit.
Die Studie selbst sagt, sie sei beobachtend und kein kausaler Beweis. Sie untersucht häufig zitierte Drittanbieter-Listicles, nicht jede Form von Erwähnung auf fremden Websites. Die beiden Werte (13,4 und 16,5) stammen aus zwei von drei untersuchten Märkten. Und die Daten wurden zwischen September 2025 und März 2026 erhoben – also vor genau der Verschiebung, die der Report dokumentiert.
Noch grundlegender: Die Umfrage erfasst, welche Maßnahmen in den vergangenen drei Monaten ausprobiert und beendet wurden. Daraus folgt nicht, dass sie nach drei Monaten Laufzeit abgebrochen wurden. Wie lange sie liefen, wie gut sie umgesetzt waren und ob später Ergebnisse gekommen wären, bleibt offen.
Wer eine Maßnahme beendet, während sich ihre Voraussetzungen verändern, handelt möglicherweise nicht ungeduldig, sondern passt seine Strategie an.
Was die Fußnoten hergeben
Die angebenen Nutzungszahlen lassen sich in den Quellen finden: Pew berichtet tatsächlich, dass 49 Prozent der US-Erwachsenen KI-Chatbots nutzen und 60 Prozent KI-Zusammenfassungen in Suchergebnissen lesen. Gefragt wurde allerdings, ob man das „jemals“ tut. Google nennt über 2,5 Milliarden monatliche Nutzer für AI Overviews. Auch die 51 Prozent wöchentliche Nutzung von KI-Tools unter britischen Erwachsenen stehen so bei YouGov.
Nur belegen diese Zahlen Nutzung, nicht Kaufrecherche! Zwischen „hat schon mal eine KI-Zusammenfassung gelesen“ und „entscheidet sich wegen einer KI-Antwort für einen Anbieter“ liegt eine Menge.
Schwächer ist das Paradebeispiel für die Attributionslücke. Beim Automatisierungsanbieter n8n schreibt Google Analytics der KI-Suche rund ein Prozent der Conversions zu, eine Nutzerbefragung rund neun. Die Zahlen stehen so im Beitrag von Graphite. Eine Stichprobengröße fehlt dort aber, die genaue Frage auch. Und dass die Differenz aus Menschen besteht, die nie auf einen Link geklickt haben, wird behauptet, nicht gezeigt. Autor ist der Graphite-CEO, der im Report zugleich als Experte zitiert wird.
Ich halte die These dahinter für plausibel. Aber auch eine Nutzerbefragung ist nicht automatisch die Wahrheit: Erinnerung und Mehrfachkontakte können die Antworten beeinflussen. Ein Einzelfall ohne ausreichende Methodenangaben ist ein dünnes Fundament für einen allgemeinen Korrekturfaktor. In unterschiedlichen Märkten und Branchen sehen wir jedenfalls sehr unterschiedliche Faktoren.
Was du daraus mitnehmen kannst
Ich würde den Report als das lesen, was er ist: eine Momentaufnahme davon, wie die befragten Marketing-Verantwortlichen über KI-Suche denken, ergänzt um Beobachtungen eines Toolanbieters aus dessen eigenem Datensatz.
Für die Praxis ziehe ich daraus fünf Dinge:
- Nicht als allgemeinen Marktbenchmark verwenden. „89 Prozent investieren mehr“ ist kein Budgetargument, und „Setup schlägt Größe“ kein Beleg für ein Organisationsmodell.
- Erst die Messmethode klären, dann die Toolfrage. Breite Prompt-Sets, wiederholte Abfragen, Zeitreihen je Plattform. Ob das ein gekauftes Tool oder ein eigenes Skript leistet, ist zweitrangig.
- Anteile und Volumina gemeinsam beobachten. Modellwechsel markieren und Zeiträume getrennt auswerten. Ein konstantes Promptset ermöglicht den Vergleich über den Wechsel hinweg.
- Eigene Seiten faktisch sauber halten. Preise, Spezifikationen, Produktnamen. Das ist ein sinnvoller Ansatzpunkt – aber kein aus diesem Report abgeleitetes Versprechen auf mehr Umsatz.
- Intern klären, was „belegt“ heißt. Die unterschiedlichen Einschätzungen nach Hierarchieebene sind ein guter Anlass, Geschäftsführung und Fachteam an einen Tisch zu holen. Eine Zitation, ein zugeordneter Lead und ein zusätzlicher wirtschaftlicher Ertrag sind drei verschiedene Dinge.
Vorsichtiger wäre ich bei allem, was der Report zu Taktiken sagt. Dass „alle dasselbe machen“ und deshalb keine Taktik mehr ein Vorteil sei, folgt aus einer Umfrage zur Nutzung, nicht aus einer Messung der Wirkung.
Der Report zeigt, wie die befragten Marketing-Verantwortlichen ihre Arbeit mit KI-Suche einschätzen und welche Veränderungen Peec in seinem Datensatz beobachtet. Welche Maßnahmen zusätzliche Sichtbarkeit oder wirtschaftlichen Erfolg verursachen, weist er nicht nach. Dafür brauchst du eigene, sauber angelegte Wirkungstests.
Abonniere das AFAIK-Update
KI verstehen. Fundiert entscheiden. Wirksam umsetzen.
Im AFAIK-Update teile ich meine Einordnungen und Erfahrungen zu KI im Unternehmen: von Strategie und sinnvollen Anwendungsfällen über die Auswahl passender Lösungen bis zur praktischen Umsetzung. Kostenlos, persönlich und mit einem klaren Blick auf Chancen und Grenzen.
Keine Sorge, ich mag Spam genauso wenig wie Du und gebe Deine Daten niemals weiter! Du bekommst höchstens einmal pro Monat eine E-Mail von mir. Versprochen.