Historischer Entwicklungsbericht. Ich beschreibe hier meine damalige Idee, Cloud-Suchfunktionen für die Analyse von Inhalten zu nutzen. Vertex AI Search ist ein Enterprise-Suchprodukt; gemeinsame Technologien oder Googles Qualitätsversprechen belegen weder identische Rankingmodelle noch dieselben Daten wie in der öffentlichen Websuche. Ein Cloud-Relevanzwert ist deshalb kein nachgewiesener Rankingfaktor für Google oder AI Overviews.
Für meinen damaligen Onlinekurs „The Future of Search“ entwickle ich gerade ein kleines Tool, mit dem man gezielt die Relevanz von Dokumenten zu Suchanfragen messen kann, um gezielter für die kommenden „AI Overviews“ oder „Search Generative Experience“ optimieren zu können. Bei meinen Recherchen bin ich auf etwas unglaublich spannendes gestoßen…
KI-generiert
Das Unternehmen hat seine Suchtechnologie, die bis dato als „Enterprise Search“ vermarktet wurde und auf den Kernbestandteilen der Google Suche basiert, für alle über die Vertex AI API verfügbar gemacht. Google beschreibt dafür semantische Such- und Matching-Technologien. Die interne Umsetzung ist nicht mit einem offengelegten RankBrain-Modell gleichzusetzen.
Diese Entwicklung eröffnet aus meiner Sicht vollkommen neue Perspektiven für SEO-Experten & -Expertinnen sowie KI-Enthusiasten & -Enthusiastinnen. Insbesondere mit Blick auf die SGE (Search Generative Experience) und Googles AI Overviews bekommt dieser Release, den wahrscheinlich die meisten nicht einmal mitbekommen haben, aus meiner Sicht eine vollkommen neue Bedeutung.
Damit lässt sich die Relevanz von Dokumenten innerhalb eines kontrollierten Cloud-Suchindex untersuchen. Das ist keine isolierte Messung des Rankings in Googles öffentlicher Websuche. Und das beste: Vertex AI Search kann noch mehr!
Kai Spriestersbach
Was ist Vertex AI Search?
Vertex AI Search ist eine sofort einsatzbereite Suchmaschine, die von der Vertex AI-Plattform von Google Cloud bereitgestellt wird. Damit können Unternehmen schnell auf generativer KI basierende Suchmaschinen für Kunden und Mitarbeiter erstellen. Wenn Sie die Qualität der Suche auf Ihren Websites verbessern möchten oder Ihre Mitarbeiter interne Daten leichter finden sollen, können Sie über Vertex AI Search ganz einfach Suchmaschinen einrichten, die Ihren Zielen entsprechen und gleichzeitig Zugriffssteuerung, Datenschutz und Datenhoheit unterstützen.
Vertex AI Search baut auf einer Vielzahl von Google-Suchtechnologien auf, darunter die semantische Suche. Durch Natural Language Processing sowie Machine Learning lassen sich so relevantere Ergebnisse als bei herkömmlichen, auf Suchbegriffen basierenden Suchverfahren bereitstellen, weil anhand der Suchanfrage des Nutzers Beziehungen innerhalb des Inhalts sowie die eigentliche Absicht erkannt werden.
Der wirklich interessante Teil ist allerdings aus meiner Sicht:
Darüber hinaus baut Vertex AI Search auf die Google-Erfahrung zum Suchverhalten der Nutzer auf und berücksichtigt bei der Reihenfolge der angezeigten Ergebnisse die Relevanz von Inhalten.
Googles Beschreibungen zeigen, dass Suchrelevanz nicht allein von isolierten Text-Embeddings abhängt. Welche Nutzersignale in welcher Form in die öffentliche Websuche einfließen, lässt sich daraus jedoch nicht vollständig ableiten. Noch weniger belegt das identische Trainingsdaten oder Modelle in Vertex AI Search. Für SEOs ist die Unterscheidung zwischen öffentlich dokumentierten Funktionen und Hypothesen über das Ranking entscheidend.
Was ist Google RankBrain?
RankBrain, eingeführt im Jahr 2015, ist ein auf maschinellem Lernen basierendes System, das Google nutzt, um Suchanfragen zu verstehen und relevante Ergebnisse zu liefern. Über Jahre hinweg haben SEOs darüber gerätselt, was sich hinter dieser Technologie verbergen könnte. Google spricht selbst von einem „Deep-Learning-Rankingsystem“.
Die interne Umsetzung der Websuche wird dadurch nicht offengelegt, denn Googles Cloud Dienst „Vertex AI Search“ nutzt von Google beschriebene Suchtechnologien, um Abfrage- und Dokumenteneinbettungsvektoren zu generieren, die semantische Beziehungen abbilden und eine semantische Suche in Google-Qualität ermöglichen.
Im Grunde handelt es sich um eine semantische Suche mit Text-Embeddings. Welche Trainingsdaten und Optimierungsverfahren im konkreten Produkt eingesetzt werden, ist damit nicht offengelegt; ein Vorteil durch öffentliche Google-Nutzerdaten ist hier nicht nachgewiesen.
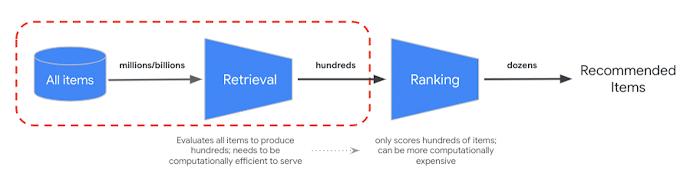
Vertex AI Search ist optimiert für RAG
Der Hauptanwendungsbereich für diese Technologie ist natürlich die Retrieval-Augmented-Generation, kurz RAG. Beim RAG-Pattern kombiniert man große Sprachmodelle (LLMs) mit einem Informationsabruf aus externen Quellen, um einige der größten Einschränkungen von LLMs zu überwinden. Insbesondere der begrenzten Wissensbasis aufgrund des Trainingsdatensatzes, dem Mangel an relevantem Kontext aus Unternehmensdaten sowie veralteten Informationen im Sprachmodell lassen sich damit begegnen.
RAG heißt im Grunde, dass die KI eine Suchmaschine als Werkzeug benutzt, um Fragen besser beantworten zu können.
LLMs sind zwar intelligent genug, um Fragen zu verstehen und diese korrekt zu beantworten, wenn man ihnen die dazu notwendigen Informationen mitliefert, aber sie können ihre Leistung nicht voll ausschöpfen, wenn die Suche nicht die richtigen Dokumente findet, in denen die notwendigen Informationen stehen!
Seit dem RAG-basierte Ansätze in KI-Tools und Suchmaschinen wie perplexity oder auch ChatGPT Einzug halten, lässt sich gut nachvollziehen, dass die Qualität eines RAG-Systems wesentlich auch von der Suchqualität des Backend-Retrievalsystems, also der Suchmaschine dahinter abhängt und die Eignung muss am jeweiligen Korpus geprüft werden.
In den letzten Monaten haben KI-Forscher und -Entwickler zahlreiche RAG-Technologien erforscht, darunter Text Chunking, Query Expansion, Hybrid Search, Knowledge Graphen, Reranking und andere. Aber fest steht: Ein LLM braucht die richtigen Daten, um die Antwort auf geeignete Quellen stützen zu können; falsche Aussagen bleiben dennoch möglich, und die Eignung des Retrievals muss am jeweiligen Datenbestand geprüft werden.
Die semantische Suche mittels Deep Learning ist heutzutage für die meisten Suchmaschinen unverzichtbar geworden. Sie ermöglicht es Entwicklern, Systeme zu erstellen, die den Sinn von Suchanfragen verstehen können, anstatt nur nach Schlüsselwörtern zu suchen. Doch die meisten RAG-Systeme verwenden relativ einfache Ähnlichkeitssuchen in Vektordatenbanken, meist auf Basis der Text-Embeddings von Suchanfrage und Dokumenten-Chunks um Informationen zu finden. Dies führt jedoch oft zu qualitativ minderwertigen und irrelevanten Ergebnissen, insbesondere bei komplexeren Fragestellungen und Fachthemen.
Exkurs: Matching-Verfahren im RAG
Es gibt verschiedene Methoden, um die Ähnlichkeit zwischen zwei Vektoren zu berechnen, die in zahlreichen Anwendungen in der Künstlichen Intelligenz zum Einsatz kommen, zum Beispiel um zu erkennen, wie ähnlich sich zwei Sätze sind.
Die übliche Methode ist Cosine Similarity, zu Deutsch Kosinus-Ähnlichkeit. Für normierte Vektoren beschreibt sie den Winkel zwischen den Vektoren; ihre Aussagekraft hängt wesentlich vom verwendeten Embedding-Modell ab.
Google hat daher in einem Forschungspapier eine verbesserte Methode vorgeschlagen. Diese nennt sich Angular Distance (Winkelabstand). Der Winkelabstand ist eine monotone Transformation der Kosinus-Ähnlichkeit und ergibt bei denselben Vektoren grundsätzlich dieselbe Rangfolge.
Bei ähnlichen Vektoren liegt der Kosinus nahe 1. Das ist eine Eigenschaft der Skala und kein Beleg fehlender Rankinginformation. Die Qualität bei kurzen Anfragen muss am Modell und den konkreten Retrieval-Aufgaben geprüft werden.
Angular Distance stellt dieselbe geometrische Beziehung auf einer anderen Skala dar. Eine allgemein bessere Genauigkeit, Robustheit oder Effizienz folgt daraus nicht. Entscheidend ist eine Evaluation mit dem gewählten Modell und realen Suchanfragen.
Es noch weitere Methoden, die ähnliche Verbesserungen bringen können. Die Wahl der besten Methode hängt vom konkreten Anwendungsfall ab. In der Regel findet zudem eine Vorverarbeitung der Texte (z.B. Stemming, Stopword-Entfernung) statt und es werden moderne Embedding-Techniken mit klassischen Relevanzkriterien (z.B. TF-IDF, BM25) kombiniert.
Semantische Suche ist mehr als nur Ähnlichkeitssuche von Texten
In wissenschaftlichen Publikationen und theoretischen Demonstration ist diese einfache Ähnlichkeitssuche sehr effektiv, da die Datensätze Millionen von Frage-Antwort-Paaren enthalten. In vielen realen RAG-Szenarien gibt es jedoch keine vorgefertigten Frage-Antwort- oder Anfrage-Kandidaten-Paare. Daher ist es wichtig, dass ein KI-Modell die Beziehung zwischen Anfragen und entsprechenden Antworten lernen und vorhersagen kann, um eine qualitativ hochwertige semantische Suche zu ermöglichen.
Google Search begann 2015 mit der Einführung der semantischen Suche, insbesondere durch das Deep-Learning-Rankingsystem RankBrain. Kurz darauf folgte das neuronale Matching, um die Genauigkeit der Dokumentensuche zu verbessern. Neuronales Matching ermöglicht es einer Suchmaschine, die Beziehungen zwischen den Absichten einer Anfrage und hochrelevanten Dokumenten zu erlernen. So kann die Suchmaschine den Kontext einer Anfrage erkennen, anstatt nur nach Ähnlichkeiten zu suchen.
Vertex AI Search ist für die Arbeit mit eigenen Dokumenten eine interessante Option. Ob die verwaltete Suche gegenüber anderen Retrieval-Verfahren Vorteile bietet, sollte auf demselben Datenbestand gemessen werden. Eine Gleichsetzung mit RankBrain oder anderen nicht vollständig offengelegten Komponenten der Google-Websuche ist dadurch nicht begründet.
Kai Spriestersbach
Neuronales Matching lernt die Beziehungen zwischen Anfragen und Dokumenten
Vertex AI Search bietet semantische Suche auf einem eigenen Dokumentenbestand. Semantische Repräsentationen können helfen, inhaltlich passende Dokumente zu einer Anfrage zu finden. Die tatsächliche Qualität hängt vom Datenbestand, den Einstellungen und der Aufgabe ab; eine allgemeine Zusage von „Google-Qualität“ lässt sich daraus nicht ableiten.
Über den Parameter task_type wird also der Anwendungszweck der Embeddings spezifiziert, um dem Modell zu helfen, Einbettungen mit höherer Qualität zu erstellen und diese Liste ist extrem interessant!
Es gibt sowohl Werte für Suchanfragen, als auch Dokumente einer Suche, sowie Texte für eine semantische Textähnlichkeit (Semantic Textual Similarity, STS). Andere NLP-Tasks wie Klassifizierung, Clustering und sogar die Beantwortung von Fragen werden offenbar jeweils mit speziell optimierten Embeddings versehen. Und sogar zur Faktenüberprüfung gibt es eigene Embeddings!
Das ist ein interessanter Funktionsumfang; eine Alleinstellung lässt sich daraus nicht ableiten.
Kai Spriestersbach
Statt alle Komponenten der Suche in einem RAG-System selbst zu entwickeln, können Unternehmen eine verwaltete Suchplattform einsetzen. Google bietet mit Vertex AI Search eine solche Lösung an und verweist dabei auf Technologien aus seiner Suchentwicklung. Daraus lässt sich nicht ableiten, dass die angebotenen Modelle identisch mit dem Ranking der öffentlichen Websuche sind oder mit deren Nutzerdaten trainiert wurden. Für die Auswahl zählen die Ergebnisse auf den eigenen Dokumenten sowie Kosten, Zugriffsrechte und Betrieb.
Google ist führend bei semantischer Suche
Entgegen der weitverbreiteten Meinung ist die semantische Suche jedoch keine neue Erfindung, die erst mit dem Aufkommen von großen Sprachmodellen populär wurde. Tatsächlich ist sie das Ergebnis jahrelanger Forschung und Entwicklung.
Google war hier schon früh Vorreiter und traf bereits 2013 die strategische Entscheidung, in die Entwicklung eigener KI-Prozessoren zu investieren – den sogenannten Tensor Processing Units (TPUs). Diese TPUs wurden speziell dafür konzipiert, die nötige Rechenleistung für maschinelles Lernen und KI-Anwendungen bereitzustellen. Ihr Ursprung liegt laut Google jedoch in dem Ziel, das für eine praxistaugliche semantische Suche erforderliche Deep Learning zu ermöglichen.
Google entwickelt sowohl spezialisierte Rechenhardware als auch Verfahren zur Vektorsuche. Ein öffentlich dokumentiertes Beispiel ist ScaNN für effiziente Ähnlichkeitssuche. Solche Entwicklungsarbeiten erklären einen Teil des technischen Hintergrunds. Sie belegen für sich allein weder die konkrete Architektur von Vertex AI Search noch dessen Qualität für eine bestimmte Unternehmensanwendung.
ScaNN kommt nicht nur bei Google Search zum Einsatz, sondern auch in vielen anderen Google-Diensten. Es findet blitzschnell relevante Dokumente und Inhalte, um Nutzern in Sekundenschnelle die benötigten Informationen zu liefern. Laut Benchmarks gehört ScaNN zu den führenden Algorithmen der Branche für die Abfrage-Verarbeitung.
Insgesamt stellen Googles bahnbrechende Suchtechnologien wie RankBrain, neuronales Matching, ScaNN und die TPU-Familie einige der wertvollsten technologischen Errungenschaften des letzten Jahrzehnts dar. Diese Technologien werden nun auch in Vertex AI Search genutzt, wodurch Entwickler Zugang zu semantischen Suchfunktionen in Google-Qualität erhalten – mit minimaler Latenz und zu vertretbaren Kosten.
Aber damit nicht genug…
Funktionen & Bedeutung für SEOs
Wenn wir unsere Inhalte und Webseiten für KI-basierte Suchmaschinen wie Perplexity, das neue bing und Googles SGE optimieren wollen, oder die Chance steigern wollen, dass Googles „AI Overviews“ Informationen von unserer Webseite zitiert, brauchen wir zunächst einmal irgendeinen Anhaltspunkt, ob wir in die richtige Richtung gehen. Wir müssen also die semantische Relevanz unserer Inhalte im Bezug auf Suchanfragen messen.
Vertex AI Search bietet uns hierfür quasi eine fertige hybride Suchmaschine an, die für jede Anfrage gleichzeitig sowohl eine Schlüsselwort- als auch eine semantische Suche auf Basis der Technologien durchführt, die Google auch in seiner eigenen Suche verwendet!
Kai Spriestersbach
Die Ergebnisse werden dann zusammengeführt und basierend auf ihren jeweiligen Bewertungen neu geordnet. Dadurch werden die Vorteile beider Suchansätze kombiniert und die Lücken, die jeder Ansatz für sich genommen lässt, geschlossen.
Ein weiterer wichtiger Aspekt ist das Verstehen und Umformulieren von Suchanfragen.
Nutzer tippen oft Suchanfragen falsch ein oder erinnern sich nicht genau an die richtigen Bezeichnungen. Hier kommen Techniken wie die Umformulierung und Erweiterung von Suchanfragen zum Einsatz.
Vertex AI Search bietet standardmäßig eine automatische, kontextbezogene Umformulierung und Erweiterung von Suchanfragen in den unterstützten Sprachen an.Dazu gehören neben der Wortstammbildung (Stemming) und Rechtschreibkorrektur auch das Hinzufügen verwandter Wörter und Synonyme sowie das Entfernen unwichtiger Wörter.
Diese Funktionen helfen der Suche dabei, die Intention hinter einer Suchanfrage besser zu verstehen und präzisere Ergebnisse zu liefern, selbst wenn die ursprüngliche Eingabe des Nutzers nicht optimal war, was insbesondere mit Blick auf die Suchmaschinenoptimierung eine wertvolle Informationsquelle darstellt.
Mit der Vertex AI Search bekommen wir nun ein Werkzeug direkt von Google an die Hand, mit dem wir ein besseres Verständnis der Nutzerintention hinter Suchanfragen erhalten, als auch überprüfen können, ob unsere Inhalte für Fragestellungen relevanter sind, als die unserer Mitbewerber!
Kai Spriestersbach
Baue einen kontrollierten Suchindex!
Wir können nun also zu einem beliebigen Keyword einfach die Top 50 der rankenden Dokumente in einen eigenen Mini-Index direkt in der Google Cloud packen, um einen eigenen Retrieval-Ansatz zu erproben und können API-Funktionen zur Extraktion und Erstellung von Inhalten testen; eine identische Verwendung in der öffentlichen Websuche ist damit nicht belegt.
Nachdem wir also die Suche mit relevanten Dokumenten gefüttert haben, kann diese uns auch noch die wichtigsten Abschnitte herausfiltern, die dann als Grundlage für das KI-Sprachmodell dienen, um Antworten zu generieren oder Zusammenfassungen zu erstellen.
Das KI-SEO-Tool der Zukunft?
Umgehauen hat es mich, als ich gesehen habe, dass Googles Vertex AI Search gleich mehrere Möglichkeiten mitbringt, um besonders relevante Inhalte aus den gefundenen Dokumenten zu extrahieren.
Jedem SEO sollten diese Beispiele von Google das Wasser im Mund zusammen laufen lassen:
Jedes Suchergebnis kann folgende Inhaltstypen umfassen, die sich aus meiner Sicht perfekt für die Verwendung in SEO-Tools eignen:
1. Textauszug für die Snippet-Optimierung
Vertex AI Search erstellt automatisch einen kurzen Ausschnitt aus dem Dokument, der einen Überblick über den Inhalt gibt. Diese Auszüge werden ähnlich wie bei Google-Suchergebnissen unter jedem Treffer angezeigt und helfen Nutzern, die Relevanz einzuschätzen.
Hiermit können SEOs Textauszüge in diesem Cloud-Produkt untersuchen. Eine Übertragung auf öffentliche Google-Snippets bleibt eine zu prüfende Hypothese.
2. Extrahierte Antwort für die Optimierung für „Featured Snippets“
Laut Googles eigener Dokumentation handelt es sich dabei um einen wörtlichen Textauszug aus dem Originaldokument, vergleichbar mit Google’s eigenen „Featured Snippets“. Diese Antworten stehen typischerweise am Anfang der Seite und bieten knappe, kontextbezogene Antworten auf Nutzeranfragen.
Hiermit lassen sich Texte also potentiell dahingehend optimieren, häufiger als Quelle für Googles Featured Snippets herangezogen zu werden!
3. Extrahierte Segmente für die Optimierung der „AI Summaries
In dieser Funktion liefert die Suche ausführlichere wörtliche Textauszüge aus einem Dokument, die mehr Kontext für KI-Sprachmodelle liefern als eine extrahierte Antwort. Diese Segmente können anschließend noch weiterverarbeitet werden, z.B. als Input für ein KI-Modell wie Gemini 1.5 um KI-generierte Zusammenfassungen zu erstellen, oder Vorschläge für die Verbesserung eines Dokumentes. Man könnte sogar den Inhalt direkt per KI verbessern, wenn man eine menschliche Qualitätssicherung nachschaltet.
Hiermit lassen sich wahrscheinlich nicht nur die „AI Summaries“ gezielt optimieren, sondern die Verbesserungen der Inhalte könnte auch zu einer Verbesserung des Rankings in der organischen Suche bei tragen und dabei sowohl die Nutzerzufriedenheit, als auch die Konversionsraten positiv beeinflussen.
Die Informationsextraktion lässt sich so konfigurieren, wie sie (mutmaßlich) auch in Googles Suche zum Einsatz kommt. So lässt sich beispielsweise die Anzahl der zu extrahierenden Textabschnitte pro Dokument festlegen, benachbarte Abschnitte für zusätzlichen Kontext einbeziehen und sogar die relevantesten Segmente auswählen oder weniger wichtige herausfiltern.
Kai Spriestersbach
Bonus: Dokumenten Handling like you are Google!!
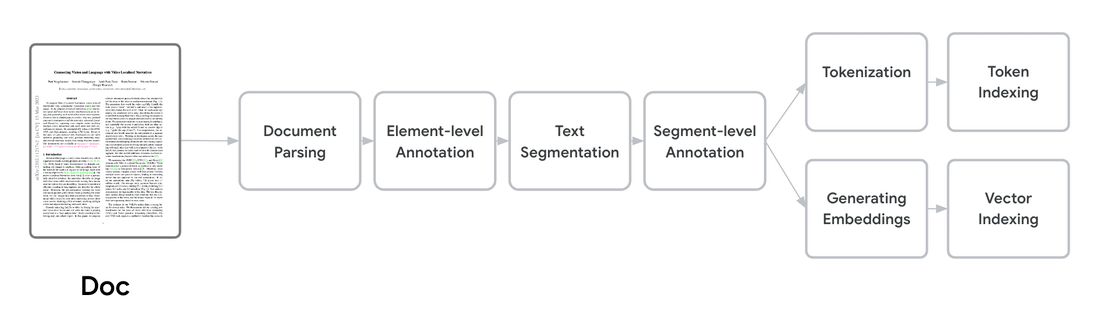
Wie jeder SEO weiß, ist es für eine Suchmaschine wichtig, die Struktur jedes Dokuments zu verstehen und sie angemessen zu verarbeiten, bevor die eigentliche Informationssuche und -bewertung stattfindet. Wer schon einmal selbst eine Suchmaschine oder ein RAG-System gebaut hat, weiß wie schwierig es sein kann, PDFs, HTML-Dateien und andere Dokumente so zu parsen und in Häppchen aufzuteilen, dass diese die Antworten der KI wirklich verbessert.
Die Dokumentverarbeitung in Vertex AI Search kann über reine Textextraktion hinausgehen und Elemente wie Überschriften, Abschnitte, Absätze und Tabellen berücksichtigen. Ob das bei den eigenen Dokumentformaten korrekt funktioniert und den Abruf verbessert, muss geprüft werden. Das ist keine Aussage über identische Verarbeitungsschritte in der öffentlichen Google-Websuche.
Diese Informationen werden genutzt, um die Dokumente intelligent in kleinere, abrufbare Segmente (Chunks) zu unterteilen. Dabei wird die Kohärenz semantischer Elemente bewahrt und Störfaktoren minimiert. Diese Methode ist effektiver als die weit verbreitete einfache Textsegmentierung, die oft die semantische Kohärenz nicht aufrechterhält.
Dieses Feature alleine hat mir nächtelang Kopfzerbrechen gemacht, als ich überlegt hatte, wie man eine KI-basierte Suche bauen würde.
Killer-Feature: Einblicke in den Knowledge Graph
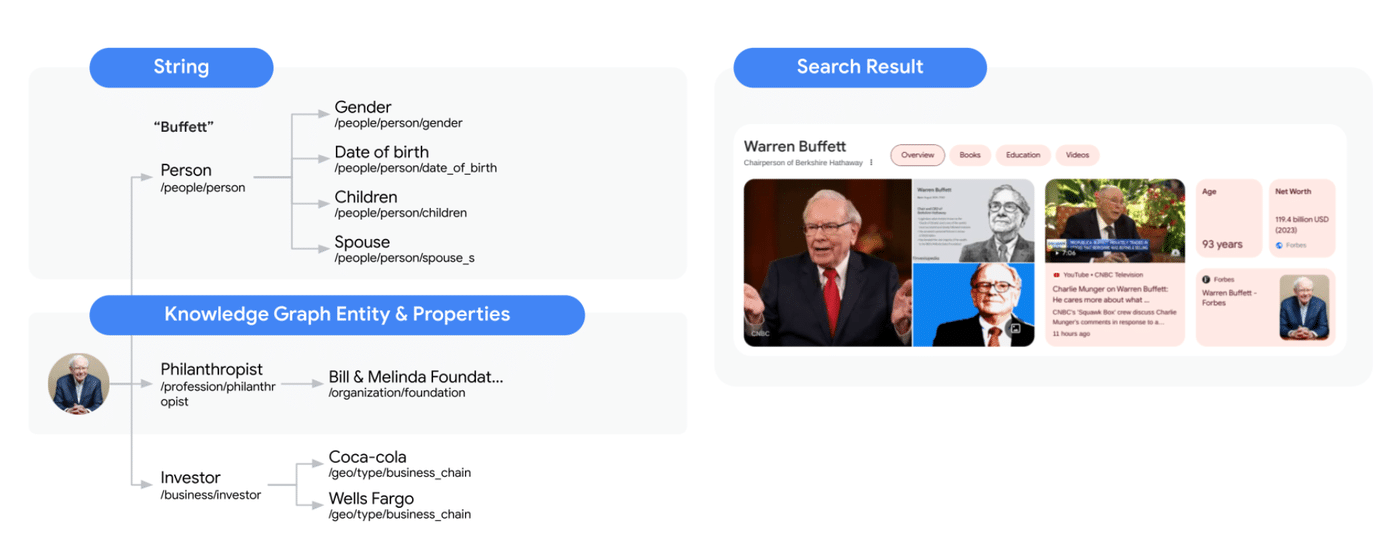
Wir sind noch nicht am Ende. Denn sogar die Entitäts-Fetischisten kommen auf ihre Kosten! Google liefert, sozusagen als Sahne auf der Torte noch eine automatische Dokumenten- und Suchanfragen-Annotation mit Wissensgraphen mit.
Falls Du mit diesem Begriff nichts anfangen kannst: Ein Wissensgraph, auf englisch Knowledge Graph findet Informationen, indem die Beziehungen zwischen Entitäten in einem Graphen genutzt werden.
Google setzt Knowledge Graphen bereits seit 2012 in der Google-Suche ein und hat sogar 2013 für 30 Millionen das Unternehmen Wavii gekauft, um seinen Knowledge Graph zu verbessern. Dieser hilft Google dabei, Suchanfragen mehr Kontext zu geben, indem sie Informationen über Dinge, Personen oder Orte liefern, die Google bereits kennt.
Die Google-Suche nutzt Wissensgraphen, um auf ihr bestehendes Wissen und Verständnis des Webs zuzugreifen und Ergebnisse zu finden, die mit der Suchanfrage des Nutzers in Verbindung stehen, wie etwa Sehenswürdigkeiten, Prominente, Städte, geografische Merkmale, Filme und vieles mehr.
Wenn beispielsweise ein Dokument oder eine Suchanfrage das Stichwort „Buffett“ enthält, ist es sehr wahrscheinlich, dass sich dieses Keyword auf Warren Buffett bezieht.
Vertex AI Search annotiert Dokumente automatisch mit zusätzlichen Informationen über ihn aus dem Wissensgraphen der Google-Suche und fügt der ursprünglichen Anfrage verwandte Keywords. Dies erhöht die Wahrscheinlichkeit, dieses Dokument auch mit anderen Stichwörtern oder Themen zu finden, die mit ihm in Verbindung stehen.
Vertex AI Search identifiziert automatisch relevante Entitäten bei Anfragen sowie der Verarbeitung oder Zusammenfassung von Dokumenten mithilfe von Wissensgraphen und fügt diese den Annotationen hinzu, welche sich anschließend in strukturierte Daten überführen und der Seite zur semantischen Auszeichnung oder für die interne Verlinkung nutzen lassen.
Kai Spriestersbach
AI Content Advanced: Grounding via Google Search
Nach der Sahne auf der Torte, hier noch die Kirsche: Automatisiert generierte Texte bieten immer die Gefahr von Halluzinationen und Falschaussagen. Um die Korrektheit generierter Texte zu überprüfen lässt sich Googles Grounding API daher mit Google Search für alle Gemini-Modelle verwenden, um quellenbasiert Texte zu erstellen.
https://www.afaik.de/googles-grounding-api/
Dabei greift Googles Sprachmodell Gemini im Hintergrund auf die Google-Suche zu und erzeugt eine Ausgabe, die mit den relevanten Suchergebnissen „gegrounded“ ist, also deren Fakten und Aussagen auf den Informationen dieser Webseiten basieren.
Damit lassen sich Modelle mit aktuellem Wissen aus dem Internet verknüpfen, oder man nutzt eine Verankerung mittels eigener Daten.
Unternehmensdaten, FAQ-Artikel, Blogbeiträge oder redaktionelle Inhalte können über einen Datenspeicher als Kontext für die Antwortgenerierung bereitgestellt werden. Das ermöglicht die Arbeit mit eigenen Quellen, garantiert aber keine korrekten Antworten. Quellenbezug, Berechtigungen und die Qualität der Antworten müssen am jeweiligen Anwendungsfall geprüft werden.
Diese Funktion befindet sich derzeit jedoch noch in der Vorschauphase.
Mein Fazit und Ausblick
Jetzt denkst du vielleicht, wow das ist eine ganze Menge. Und wenn du – wie ich – vorhast, diese Technologien für deine eigene SEO-Arbeit zu nutzen, hast du Recht.
Um derartig fortschrittliche Suchtechnologien zu implementieren, die eine mit der Google-Suche vergleichbare Suchqualität liefern, egal ob du sie GenAI verwendest oder nicht, bräuchtest du Jahre der Entwicklung und die Einstellung einer Vielzahl von Datenwissenschaftlern und Ingenieuren mit Spezialkenntnissen in ML, Suchmaschinen, DevOps und MLOps.
Oder einfach einen Account bei Googles Vertex AI Cloud.
Kai Spriestersbach
Ich bin, wie du vielleicht beim Lesen gemerkt hast, ziemlich gehyped, denn für SEOs eröffnet die Verfügbarkeit von Googles bislang geheimen Technologien wie RankBrain und dem Knowledge Graphen über Vertex AI vollkommen neue Möglichkeiten für Innovationen im Bereich der Suchmaschinenoptimierung.
Dazu liefert Google quasi die Technologie zur Verbesserung und Erstellung von Inhalte mit und bietet mit der Grounding API sogar endlich die Möglichkeit, die Korrektheit der generierten Aussagen zu verbessern.
Ich bin extrem gespannt, welche Toolanbieter zuerst von den neuen Möglichkeiten gebrauch machen werden. Damals plante ich, Vertex AI für meinen eigenen KI-SEO-Stack zu erproben. Leider ist die Dokumentation aktuell noch ziemlich inkonsistent und weist große Lücken auf.
Wenn Du wissen willst, wie Du diese Technologien für Dein eigenes SEO in Zukunft nutzen kannst, frage nach dem aktuellen Format meines Kurses, Termine und Verfügbarkeit stimmen wir persönlich ab.
Die aktuelle Google-Dokumentation führt das Produkt unter Agent Search und nennt frühere Produktnamen. Für meinen Ansatz bleibt entscheidend, ob kontrollierte Tests einen Zusammenhang zwischen Cloud-Relevanz, Inhaltsqualität und tatsächlicher Sichtbarkeit zeigen. Das wäre eine empirische Prüfung, keine Ableitung aus dem Produktnamen.
KI verstehen. Fundiert entscheiden. Wirksam umsetzen.
Im AFAIK-Update teile ich meine Einordnungen und Erfahrungen zu KI im Unternehmen: von Strategie und sinnvollen Anwendungsfällen über die Auswahl passender Lösungen bis zur praktischen Umsetzung. Kostenlos, persönlich und mit einem klaren Blick auf Chancen und Grenzen.
Keine Sorge, ich mag Spam genauso wenig wie Du und gebe Deine Daten niemals weiter! Du bekommst höchstens einmal pro Monat eine E-Mail von mir. Versprochen.
Ich bin Kai Spriestersbach, M.Sc. in Web Science. Ich verbinde Forschung zu generativer KI mit Erfahrung als Head of AI, technischer Entwicklung und unternehmerischer Praxis.
Mit AFAIK unterstütze ich Unternehmen und Investoren bei KI-Strategie, der Prüfung technischer und wirtschaftlicher Annahmen sowie vereinbarter Entwicklung. Auf AFAIK teile ich wissenschaftliche Quellen, technische Erfahrungen und nachvollziehbare Einschätzungen – mit ihren Möglichkeiten, Grenzen und offenen Fragen.

 KI-generiert