 KI-generiert
Ian P. McCarthy, Timothy R. Hannigan und André Spicer haben sich in einem sehr guten Artikel im Harvard Business Review dem Thema Halluzinationen von Chatbots und großen Sprachmodellen angenommen und das Ganze mal aus Sicht des Risikomanagements von Unternehmen bewertet.
Sie verwenden für ungenaue und unwahre Inhalte von Chatbots, die von Menschen unkritisch für Aufgaben verwendet werden den Begriff „Botshit“ und machen zu Recht darauf aufmerksam, dass dieser erhebliche Risiken für Unternehmen darstellen kann. Dazu gehören Reputationsschäden, Fehlentscheidungen, rechtliche Haftung, wirtschaftliche Verluste und sogar Gefährdung der menschlichen Sicherheit.
Auf absehbare Zeit ist es unwahrscheinlich, dass Chatbots verschwinden werden und auch wenn RAG und Grounding-Techniken die Assistenten zuverlässiger machen und die KI-Forscherinnen und -Forscher mit Hochdruck an zuverlässigeren Modellen arbeitet, müssen wir uns die Frage stellen, wie Unternehmen diese Risiken managen und gleichzeitig die Vorteile dieser vielversprechenden neuen Werkzeuge nutzen können.
Die Autoren schlagen vor, basierend auf ihrer Forschung zwei Schlüsselfragen zu stellen:
- Wie wichtig ist die Richtigkeit der Chatbot-Antwort für eine bestimmte Aufgabe?
- Wie schwierig ist es, die Richtigkeit der Chatbot-Antwort zu überprüfen?
Anhand der Antworten auf diese Fragen können Unternehmen Risiken strukturieren und passende Kontrollen auswählen. Ob diese ausreichend wirken, muss im konkreten Einsatz geprüft werden.
Die Autoren erläutern verschiedene Vorfälle, bei denen der unkritische Einsatz von Chatbots zu Problemen geführt hat. Zum Beispiel führte ein Fehler des Google-Chatbots Bard zu einem massiven Kurssturz der Alphabet-Aktie. In einem anderen Fall wurden zwei Anwälte mit Geldstrafen belegt, weil sie von ChatGPT generierte fiktive Rechtsfälle eingereicht hatten.
Um die Risiken von „Botshit“ zu managen, schlagen die Autoren vier Kategorien von Aufgaben vor, bei denen Chatbots eingesetzt werden können:
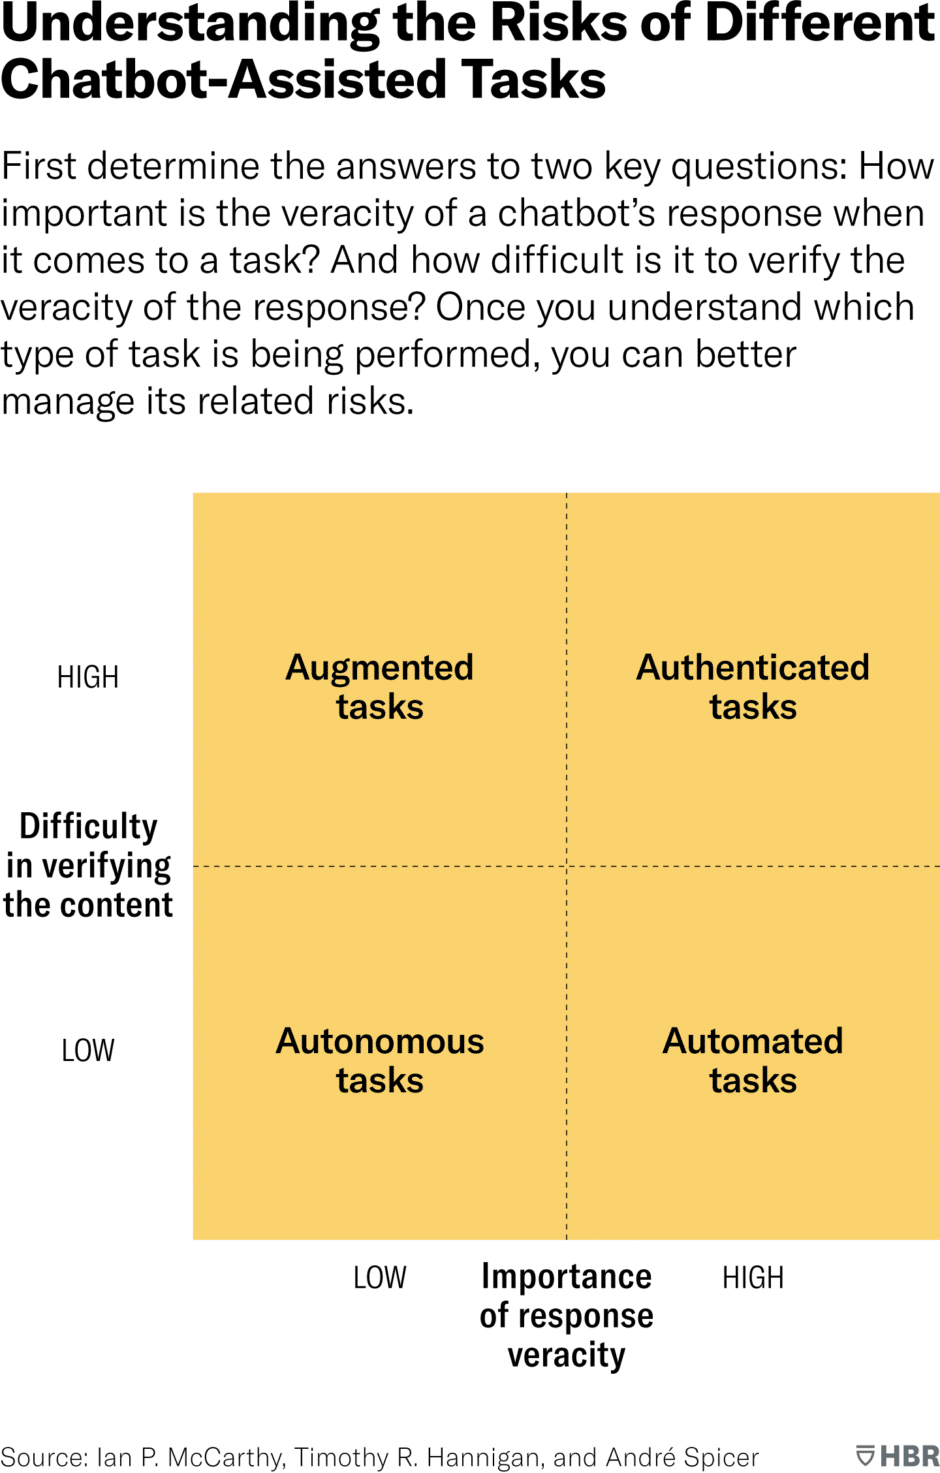
- Authentifizierte Aufgaben: Hier ist die Richtigkeit entscheidend, aber schwer zu überprüfen. Das größte Risiko ist eine falsche Kalibrierung. Eine Modellkalibrierung allein genügt hier nicht. Wenn Fehler gravierend und schwer erkennbar sind, können unabhängige Fachprüfung oder ein Verzicht auf diesen Einsatz nötig sein.
- Erweiterte Aufgaben: Die Genauigkeit ist weniger wichtig und schwer zu überprüfen. Das Hauptrisiko ist Unwissenheit. Dies kann durch den Einsatz menschlicher Experten zur Ergänzung der Chatbot-Antworten gemindert werden.
- Automatisierte Aufgaben: Genauigkeit ist wichtig und leicht zu überprüfen. Das Risiko liegt in der übermäßigen Routinisierung. Dies kann durch regelmäßige menschliche Überprüfung gemindert werden.
- Autonome Aufgaben: Genauigkeit ist weniger wichtig und leicht zu überprüfen. Das Risiko besteht in einer „Black Box“. Dies kann durch Einschränkung des Einsatzbereichs und strenge Leitplanken gemindert werden.
Zusammenfassend lässt sich sagen, dass Chatbots und andere KI-Werkzeuge ein großes Potenzial haben, viele Arbeitsprozesse erheblich zu verbessern. Wie bei jeder wichtigen neuen Technologie bringen sie jedoch auch Risiken mit sich. Bei sorgfältigem Management können diese Risiken eingedämmt werden, während gleichzeitig die Vorteile genutzt werden können.
Ich finde den Artikel sehr lesenswert, insbesondere weil die Autoren nicht so tun, als ließen sich Halluzinationen technisch lösen oder ignorieren, sondern liefern für unterschiedliche Aufgaben differenzierte Ansätze für eine Mitigierung der Risiken.
Ich würde diese Matrix für einen konkreten Ablauf um drei Fragen ergänzen: Wer kann einen Fehler erkennen? Bevor welche Entscheidung fällt, muss diese Prüfung stattfinden? Und was passiert, wenn keine belastbare Antwort vorliegt? Bei einer Ideenliste kann ein unbrauchbarer Vorschlag aussortiert werden. Bei einer folgenreichen fachlichen Entscheidung braucht es eine andere Kontrolle. Im KI-Pilotprojekt sollten deshalb Fehler, Prüfaufwand und Nacharbeit ebenso gemessen werden wie Zeitersparnis.
Abonniere das AFAIK-Update
KI verstehen. Fundiert entscheiden. Wirksam umsetzen.
Im AFAIK-Update teile ich meine Einordnungen und Erfahrungen zu KI im Unternehmen: von Strategie und sinnvollen Anwendungsfällen über die Auswahl passender Lösungen bis zur praktischen Umsetzung. Kostenlos, persönlich und mit einem klaren Blick auf Chancen und Grenzen.
Keine Sorge, ich mag Spam genauso wenig wie Du und gebe Deine Daten niemals weiter! Du bekommst höchstens einmal pro Monat eine E-Mail von mir. Versprochen.